Classificazioni · 1 min di lettura
Classificazione dei modelli
Classifica modelli di completamento, embedding, trascrizione e generazione immagini in base a dove e come vengono eseguiti.
Ogni tipo di modello viene classificato separatamente, perché ciascuno tratta i tuoi dati in modo diverso. Un modello di completamento ragiona sul testo, un modello di embedding converte i documenti in una forma ricercabile, un modello di trascrizione ascolta l’audio.
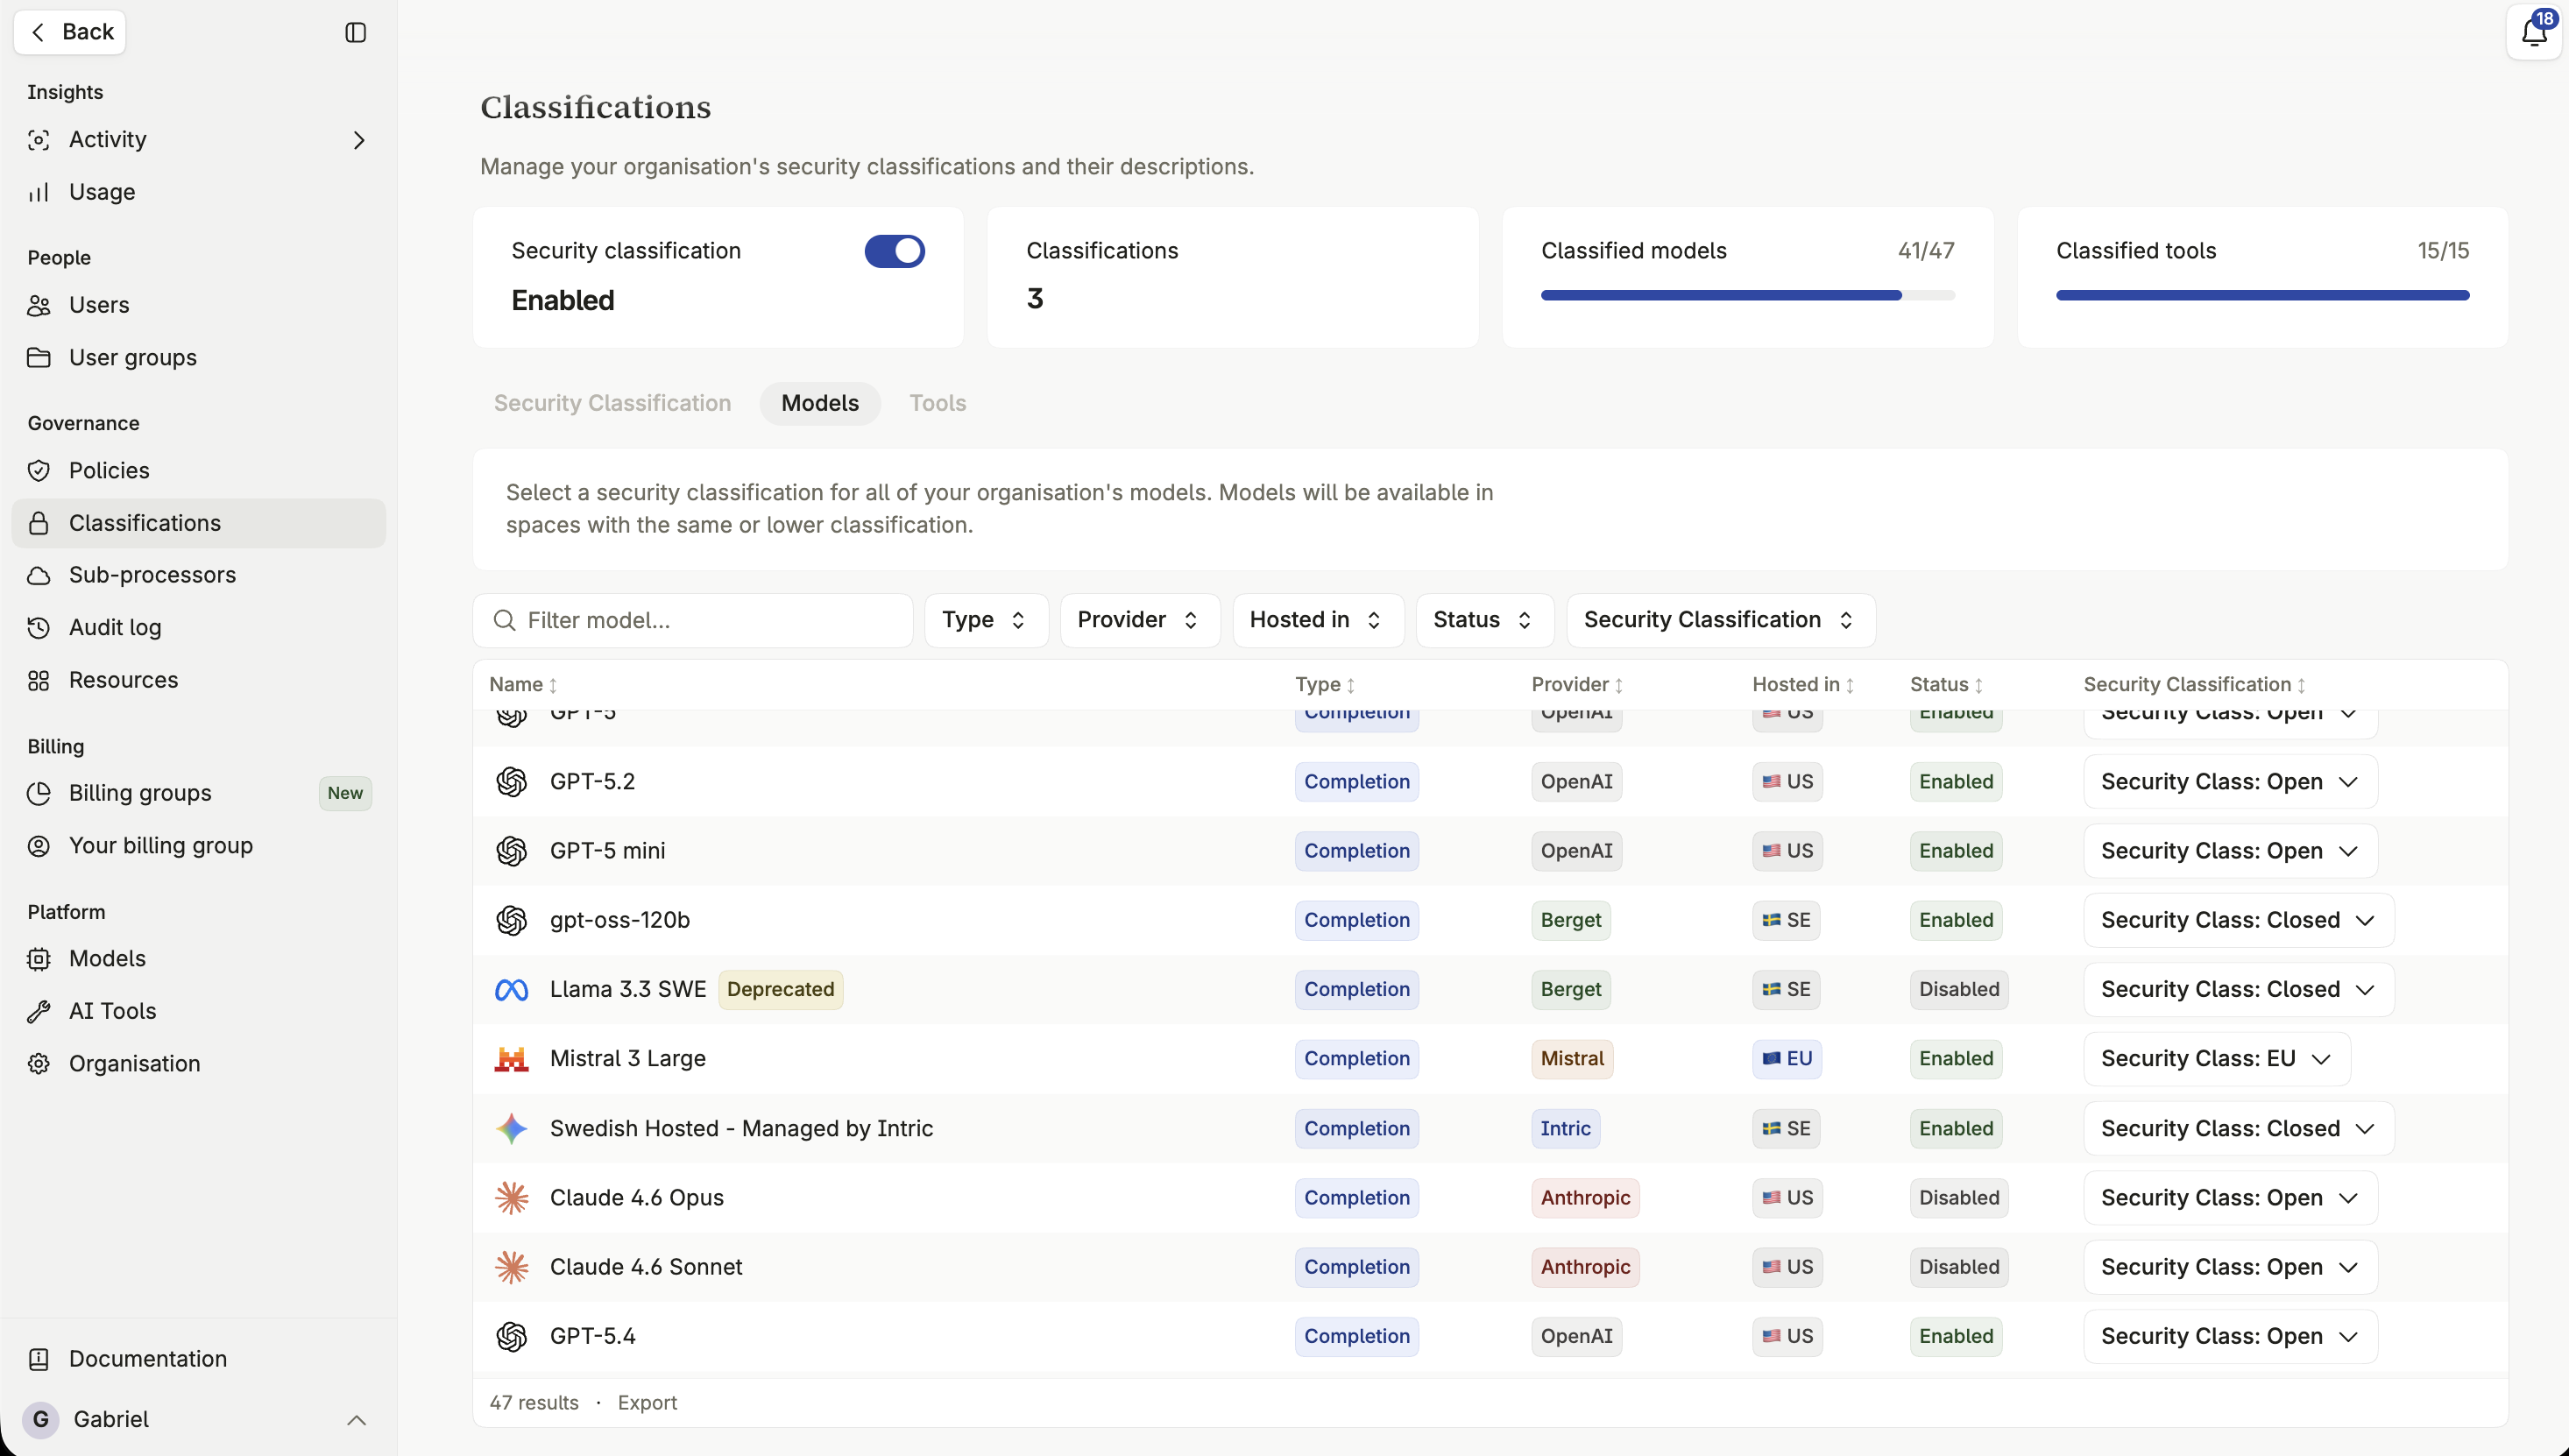
I tipi di modello
Sezione intitolata “I tipi di modello”Modelli di completamento
Sezione intitolata “Modelli di completamento”Il “motore” che genera testo e ragiona sulle istruzioni. Un modello potente ospitato fuori dall’UE potrebbe essere classificato basso (Aperto), mentre un modello ospitato localmente può essere classificato più in alto (Sensibile o Confidenziale). Grazie all’ereditarietà, quel modello locale diventa automaticamente disponibile anche alle classificazioni inferiori.
Modelli di embedding
Sezione intitolata “Modelli di embedding”Convertono i tuoi documenti in vettori ricercabili.
Modelli di trascrizione
Sezione intitolata “Modelli di trascrizione”Convertono il parlato in testo. Se una registrazione contiene informazioni sensibili, il suo modello di trascrizione ha bisogno di una classificazione corrispondente.
Modelli di generazione immagini
Sezione intitolata “Modelli di generazione immagini”Generano e modificano immagini a partire da descrizioni testuali.
Un solo modello di embedding per classificazione
Sezione intitolata “Un solo modello di embedding per classificazione”Usare la colonna del sub-processore
Sezione intitolata “Usare la colonna del sub-processore”La riga di ogni modello mostra il suo sub-processore — l’azienda che tratta direttamente i dati quando il modello viene eseguito: il fornitore del modello per un modello ospitato esternamente, oppure il fornitore di infrastruttura di Intric per un modello che Intric ospita direttamente. Usa questa colonna quando rivedi i tuoi accordi sul trattamento dei dati (DPA) o decidi quali modelli sono appropriati per una data classificazione.