Klassifizierungen · 1 Min. Lesezeit
Modellklassifizierung
Klassifiziere Completion-, Embedding-, Transkriptions- und Bildmodelle danach, wo und wie sie laufen.
Jeder Modelltyp wird einzeln klassifiziert, weil jeder auf eine andere Weise mit euren Daten in Berührung kommt. Ein Completion-Modell verarbeitet den Text und zieht daraus Schlüsse, ein Embedding-Modell wandelt Dokumente in durchsuchbare Form um, ein Transkriptionsmodell hört sich das Audio an.
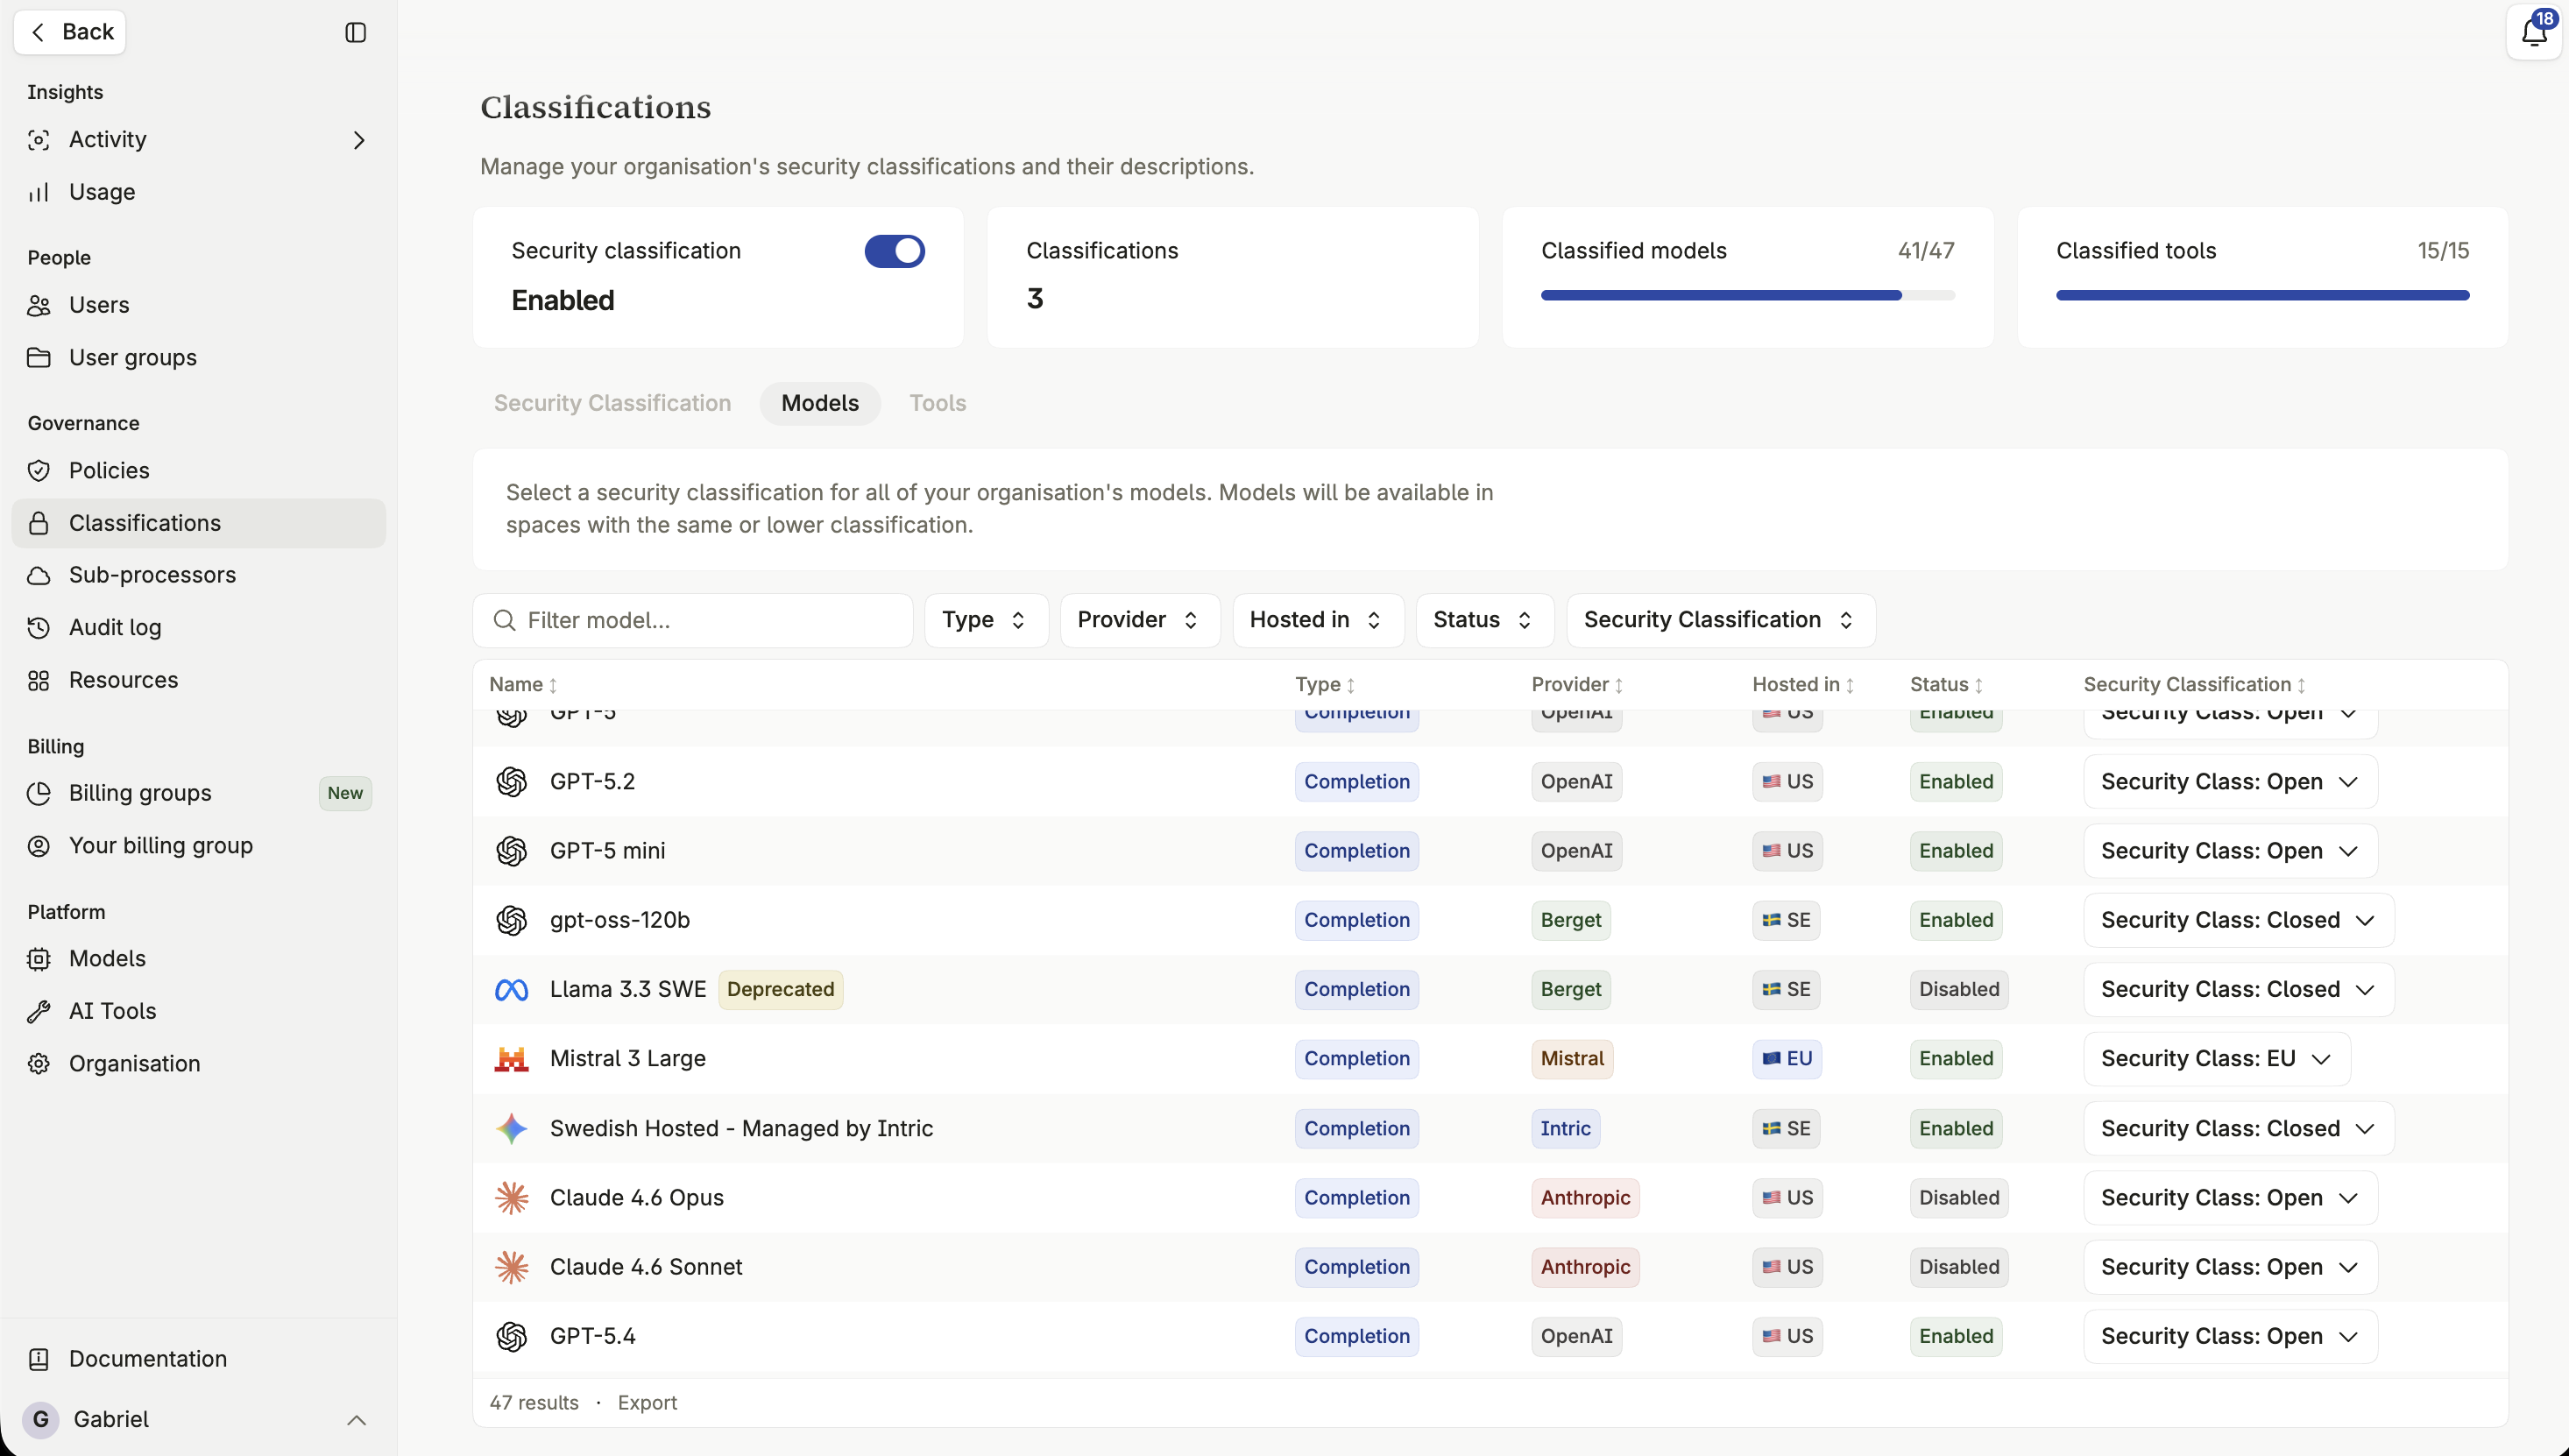
Die Modelltypen
Abschnitt betitelt „Die Modelltypen“Completion-Modelle
Abschnitt betitelt „Completion-Modelle“Der „Motor“, der Text erzeugt und über Anweisungen nachdenkt. Ein leistungsfähiges, außerhalb der EU gehostetes Modell lässt sich niedrig einstufen (Offen), während ein lokal gehostetes Modell höher eingestuft werden kann (Sensibel oder Vertraulich). Dank Vererbung steht dieses lokale Modell dann automatisch auch auf den niedrigeren Klassifizierungen zur Verfügung.
Embedding-Modelle
Abschnitt betitelt „Embedding-Modelle“Wandeln eure Dokumente in durchsuchbare Vektoren um.
Transkriptionsmodelle
Abschnitt betitelt „Transkriptionsmodelle“Wandeln Sprache in Text um. Enthält eine Aufnahme sensible Informationen, braucht das dafür genutzte Transkriptionsmodell eine passende Klassifizierung.
Bildmodelle
Abschnitt betitelt „Bildmodelle“Erzeugen und bearbeiten Bilder aus Textbeschreibungen.
Ein Embedding-Modell pro Klassifizierung
Abschnitt betitelt „Ein Embedding-Modell pro Klassifizierung“Die Spalte für Unterauftragsverarbeiter nutzen
Abschnitt betitelt „Die Spalte für Unterauftragsverarbeiter nutzen“Die Zeile jedes Modells zeigt seinen Unterauftragsverarbeiter — das Unternehmen, das beim Ausführen des Modells direkt die Daten verarbeitet: den Modellanbieter bei einem extern gehosteten Modell, oder Intrics eigenen Infrastrukturanbieter bei einem Modell, das Intric selbst hostet. Nutze diese Spalte, wenn du eure Auftragsverarbeitungsverträge prüfst oder entscheidest, welche Modelle für eine bestimmte Klassifizierung geeignet sind.