Klassifiseringer · 1 min lesing
Modellklassifisering
Klassifiser fullførings-, embedding-, transkripsjons- og bildemodeller etter hvor og hvordan de kjører.
Hver modelltype klassifiseres for seg, fordi hver av dem berører dataene dine på ulikt vis. En fullføringsmodell resonnerer over teksten, en embedding-modell gjør dokumenter søkbare, en transkripsjonsmodell lytter til lyden.
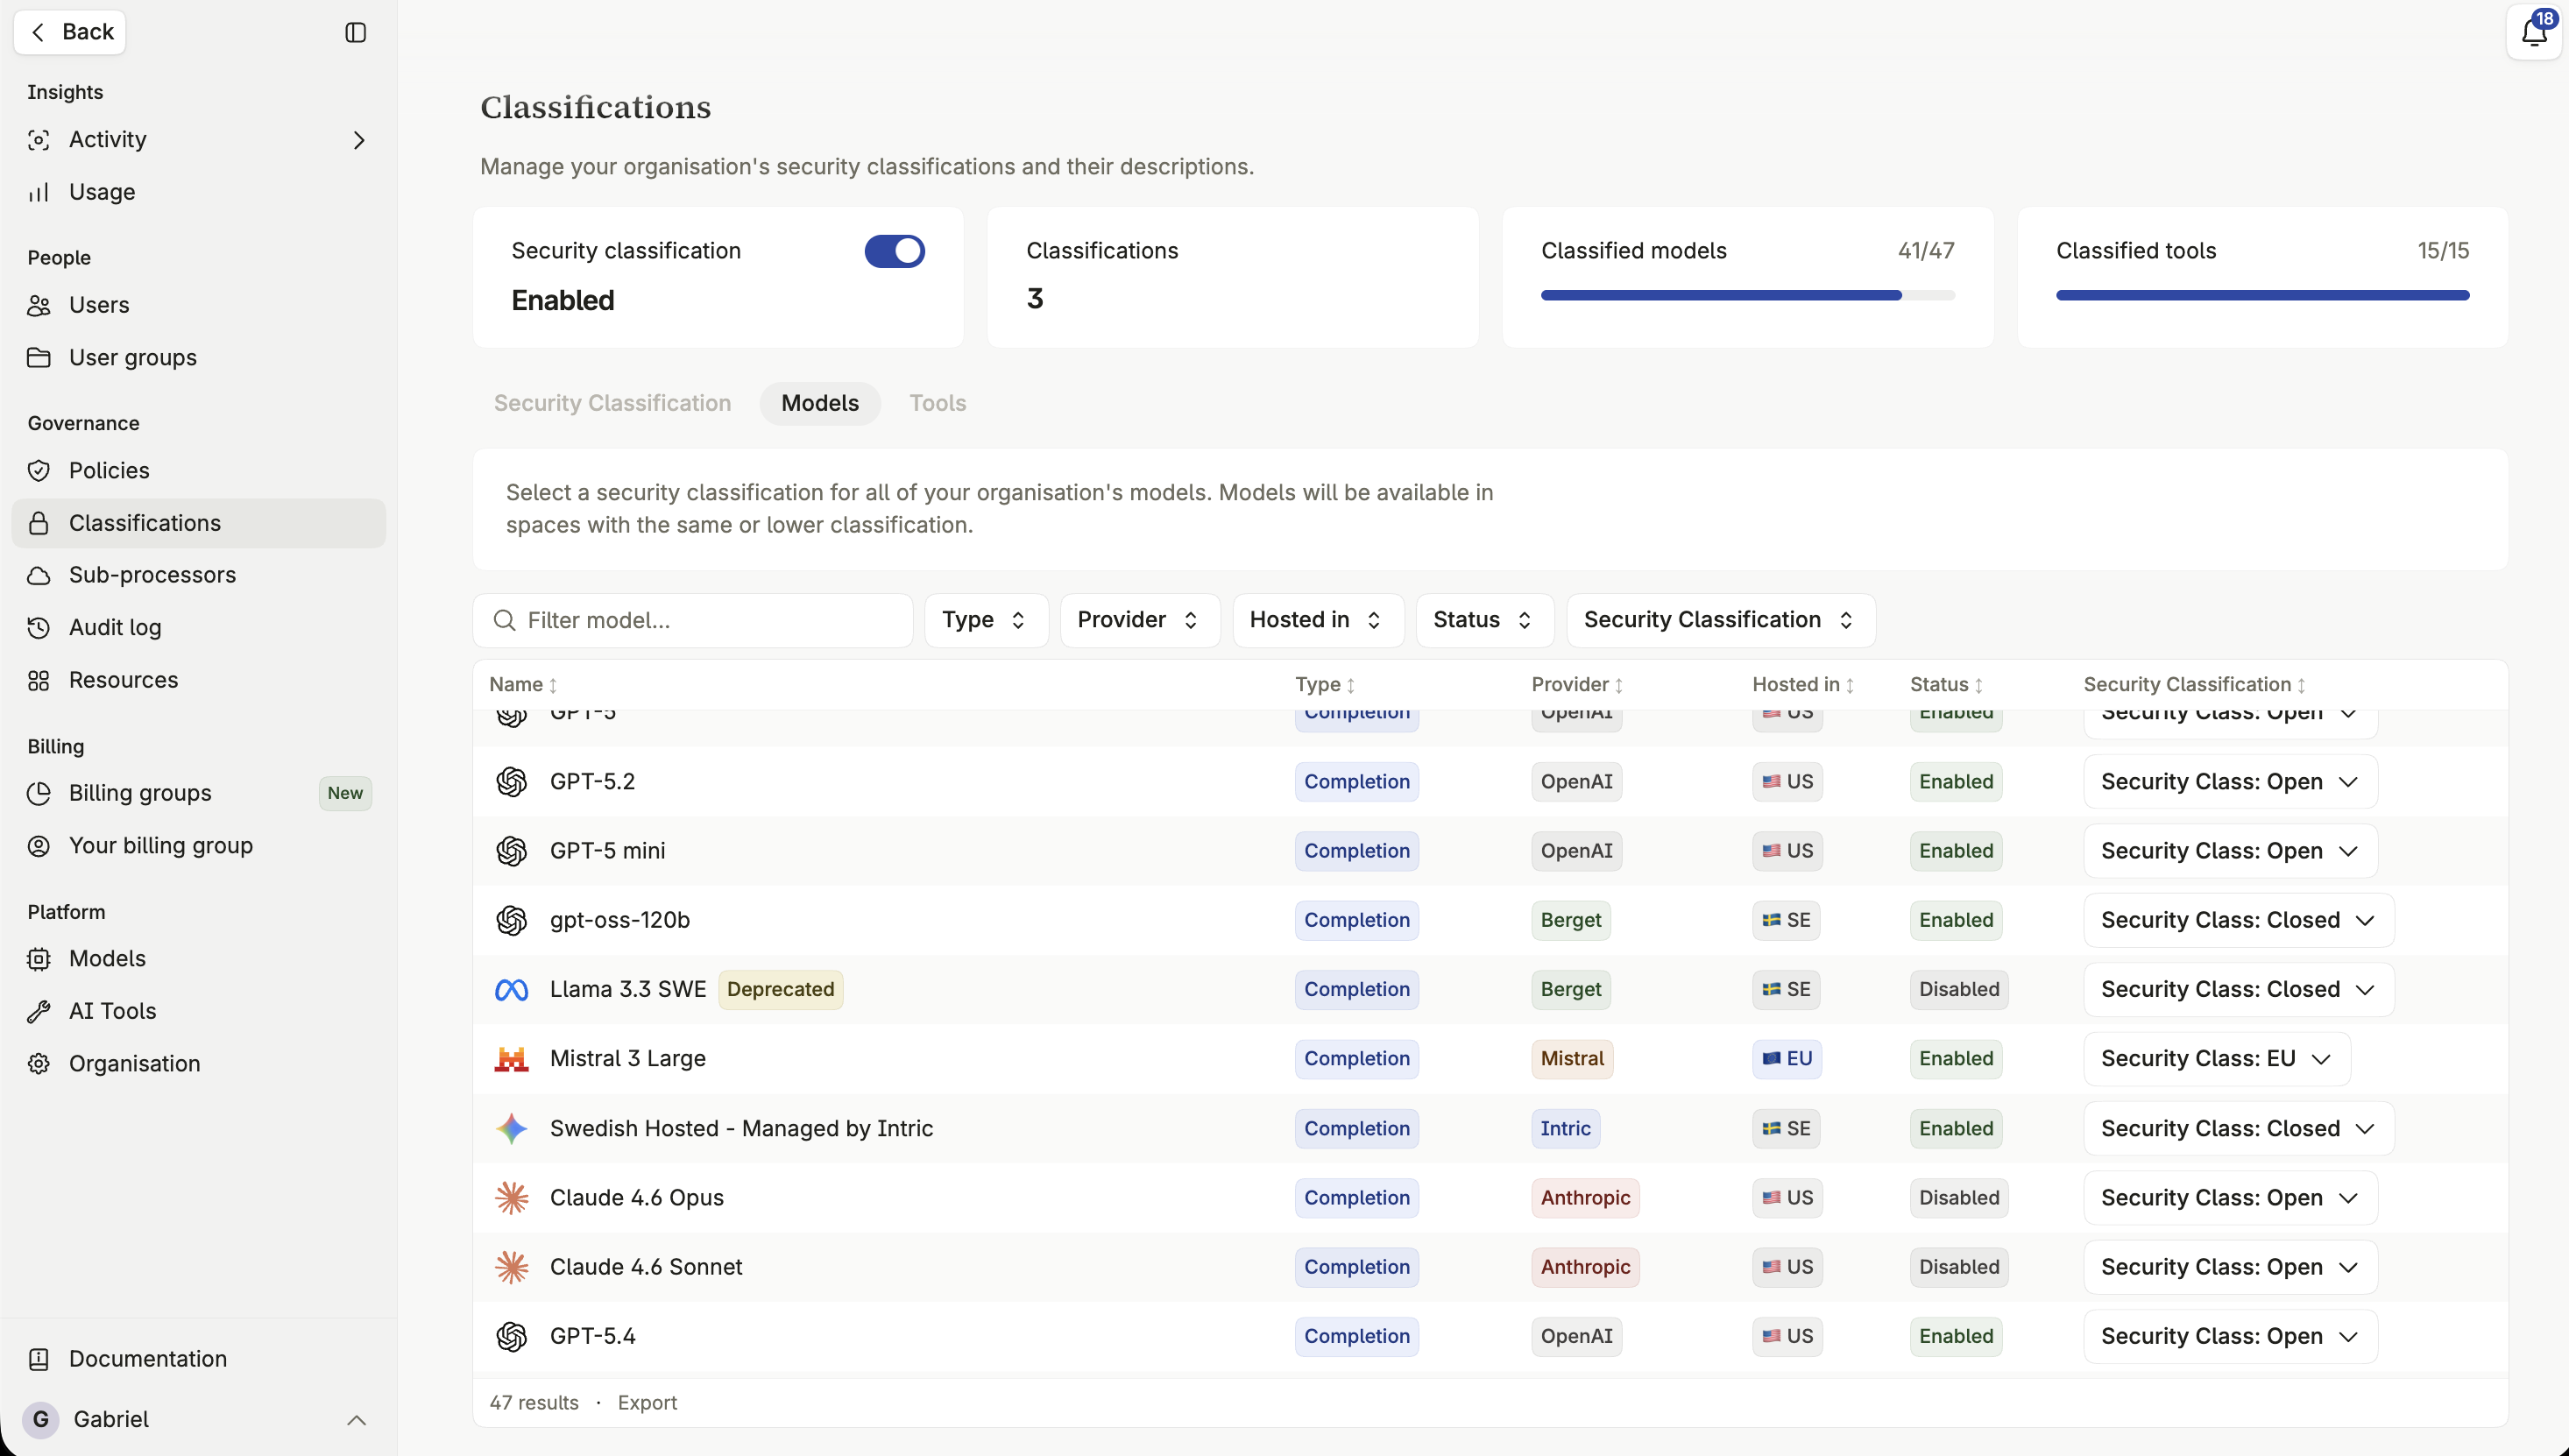
Modelltypene
Section titled “Modelltypene”Fullføringsmodeller
Section titled “Fullføringsmodeller”«Motoren» som genererer tekst og resonnerer over instruksjoner. En kraftig modell hostet utenfor EU kan klassifiseres lavt (Åpen), mens en lokalt hostet modell kan klassifiseres høyere (Sensitiv eller Konfidensiell). Takket være arv blir den lokale modellen automatisk tilgjengelig på de lavere klassifiseringene også.
Embedding-modeller
Section titled “Embedding-modeller”Gjør dokumentene dine søkbare ved å konvertere dem til vektorer.
Transkripsjonsmodeller
Section titled “Transkripsjonsmodeller”Konverterer tale til tekst. Inneholder et opptak sensitiv informasjon, trenger transkripsjonsmodellen en klassifisering som matcher.
Bildemodeller
Section titled “Bildemodeller”Genererer og redigerer bilder ut fra tekstbeskrivelser.
Hvor en modell kjører, ikke bare hvordan den er klassifisert
Section titled “Hvor en modell kjører, ikke bare hvordan den er klassifisert”Klassifiseringen avgjør om en modell passer for et gitt sensitivitetsnivå. Den sier ingenting om hvor modellen fysisk kjører. Det avgjør vertsregionen til underdatabehandleren, og den begrenser du separat ved å sette behandlingsregioner på klassifiseringen. En modell kan være riktig klassifisert og likevel være utilgjengelig fordi den kjører utenfor de tillatte regionene. Les mer i Behandlingsregioner.
Én embedding-modell per klassifisering
Section titled “Én embedding-modell per klassifisering”Bruke underdatabehandler-kolonnen
Section titled “Bruke underdatabehandler-kolonnen”Hver modells rad viser dens underdatabehandler — selskapet som direkte behandler data når modellen kjører: modellleverandøren for en eksternt hostet modell, eller Intrics egen infrastrukturleverandør for en modell Intric hoster selv. Bruk denne kolonnen når du går gjennom databehandleravtalene dine, eller når du vurderer hvilke modeller som er egnet for en gitt klassifisering.